

こんにちは、ネットアシスト運用チームのhaokiです。
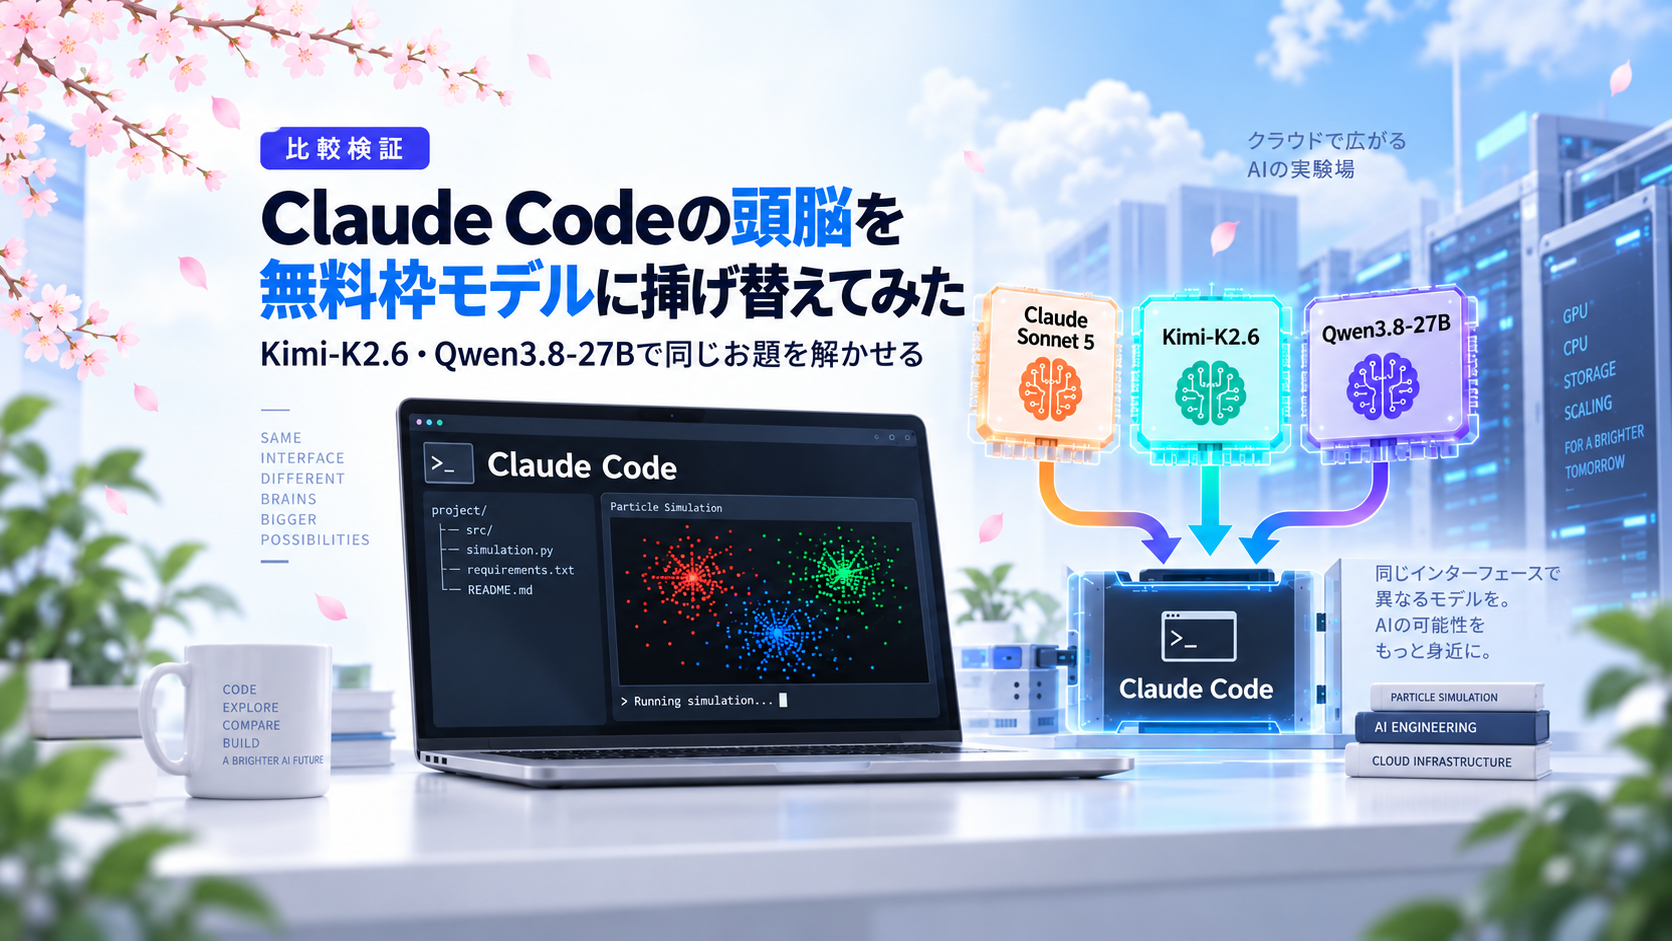
Claude Codeは、Anthropicの「Messages API」という規格に沿ってリクエストを投げているだけのツールです。そしてリクエストの送信先は環境変数で差し替えられます。さくらのAI Engineも同じMessages API互換のエンドポイントを提供しているので、公式サイトにも「Claude Codeなどのツールから直接利用できます」と明記されています。
車に例えるなら、ボディとハンドル(Claude Codeという操作体験)はそのままに、エンジン(実際に考えているモデル)だけを載せ替えるようなものです。
同じ器で同じお題を解かせて比べれば、エンジンの実力差がそのまま見えるはずです。
モデルを並べて比べてみました、で終わらせるつもりだったのですが、検証の途中で、思考ログには「Writeツールでファイルを作成する」と書いてあるのにファイルが1つも作られていない、という現象に遭遇しました。エラーは出ませんし、処理も正常に完了したように見えます。lsでタイムスタンプを見るまで気づきませんでした。
原因の特定に至るまでの経緯と、無料枠モデルの実力測定の結果をあわせて紹介します。
検証環境
| 項目 | 内容 |
|---|---|
| Claude Code | v2.1.268 |
| 比較対象①(本家・有料) | Claude Sonnet 5(Anthropic API直結) |
| 比較対象②(無料枠) | Kimi-K2.6(さくらのAI Engine パブリックプレビュー) |
| 比較対象③(自前ホスト) | Qwen3.8-27B(2026年8月14日公開、Apache 2.0) |
| ③のホスト環境 | 高火力VRT / 24Core-240GB-H100x1(石狩第1ゾーン) |
| ③のOS・推論サーバ | Ubuntu Server 24.04.2 LTS / vLLM 0.29.0 |
| 操作端末 | WSL2(AlmaLinux 9) |
②のKimi-K2.6は、さくらのAI Engineの「パブリックプレビューモデル」に分類されるものです。実利用環境での検証とフィードバック収集を目的とした提供で、予告なく終了する可能性がある点は頭に入れておく必要があります。そのかわり、チャット生成は月3,000リクエストまで無償枠の対象です。
③のQwen3.8-27Bは、さくらのAI Engineのラインナップにまだ入っていないモデルです。重みが公開されている(オープンウェイト)ので、「無料枠にないなら自分で立てればいいのでは」という発想で高火力VRTに載せました。結論から言うと、この選択が検証時間の8割を消費することになります。
お題:名前のないシミュレーション
3モデルに一字一句同じプロンプトを投げます。
HTML+Canvas単一ファイルで、以下の仕様の粒子シミュレーションを実装してください。

- Canvas上に80個の粒子を配置する。各粒子は赤・緑・青のいずれかの色を持つ(開始時はランダムに均等配分)
- 各粒子は、自分と同じ色の粒子には弱い引力を、違う色の粒子には弱い斥力を及ぼす
- 引力・斥力は距離の逆数に比例し、近すぎる場合は反発を強めて衝突を防ぐ
- 毎フレーム、力に応じて粒子の速度を更新し、位置を移動させる。画面端では跳ね返る
- 画面右上に、現在の「同色クラスタ数」(隣接する同色粒子のグループ数)をテキストで常時表示する
- 単一のHTMLファイルとして、外部ライブラリなしで実装してください
お題選びでは2つの条件を意識しました。
ひとつは、名前の付いたアルゴリズムを避けることです。「Boidsで群れを作って」だと、モデルがGitHubに転がっている実装を記憶から引き出しているだけの可能性を否定できません。名前のない自作ルールなら、仕様を読んで組み立てる力を素直に測れます。
もうひとつは、成功か失敗かが一目で分かること。「同色の粒子が集まって色ごとの塊になる」という結果は、コードを読まなくてもブラウザを開いた瞬間に判定できます。右上のクラスタ数表示も仕様に含めておいて、数値でも裏が取れるようにしました。
ハマりどころ1:api_keyで渡すと401になる
まずはKimi-K2.6への接続です。環境変数を差し替えるだけのはずでした。
export ANTHROPIC_BASE_URL="https://api.ai.sakura.ad.jp"
export ANTHROPIC_API_KEY="<発行したトークン>"結果はAPI Error: 401。
原因は認証方式の違いでした。Anthropicの流儀では、api_keyで渡した値はx-api-keyというヘッダーに、auth_tokenで渡した値はAuthorization: Bearer ...というヘッダーに乗ります。さくらのAI EngineのAnthropic互換APIは後者のBearer認証を使うため、auth_token側で渡さないと通りません。トークン自体が正しくても、届く場所が違うので認証されない、というわけです。
unset ANTHROPIC_API_KEY
export ANTHROPIC_BASE_URL="https://api.ai.sakura.ad.jp"
export ANTHROPIC_AUTH_TOKEN="<トークンID>:<シークレット>"
export ANTHROPIC_MODEL="preview/Kimi-K2.6"トークンの形式にも注意が必要です。コントロールパネルに表示される「アカウントトークンID」だけでは足りず、<トークンID>:<シークレット>をコロンで連結した1本の文字列を渡します。
なお、現時点でMessages API経由で使えるモデルはpreview/Kimi-K2.6のみです。gpt-oss-120bなどをClaude Codeから使いたい場合は、この経路では選べません。
ここまで直せば、あとはclaudeを起動するだけで繋がりました。
▐▛███▛█   Claude Code v2.1.268
▝▜██████▀  preview/Kimi-K2.6 · API Usage Billing
ハマりどころ2:自前ホスティングは4段構えのドライバ地獄
次にQwen3.8-27Bです。こちらはさくらのAI Engineに無いモデルなので、高火力VRTでH100を1枚借りて、自分で推論サーバを立てます。使ったのはvLLMというOSSで、Hugging Faceからダウンロードしたモデルを読み込んで、OpenAI互換やAnthropic互換のAPIとして公開してくれるものです。
ここからが長い道のりでした。
CUDAドライバのバージョンが合わない
CUDA Toolkit 12.9を公式マニュアルどおりに導入した状態でvllm serveを叩くと、こうなります。
RuntimeError: The NVIDIA driver on your system is too old (found version 12090).最新のvLLM(0.29.0)が引いてくるPyTorchはCUDA 13.0向けビルドで、ドライバ側が追いついていませんでした。
厄介だったのはここからです。apt-get install cuda-driversを実行するとalready the newest version (615.71.09)と返ってくるのに、nvidia-smiは575のまま変わりません。
$ dpkg -l | grep -i cuda-drivers
ii  cuda-drivers:amd64  615.71.09-1ubuntu1  amd64  Transitional dummy package
Transitional dummy package ——実体を持たない移行用の空パッケージでした。依存関係を辿っても何も出てきません。
$ apt-cache depends cuda-drivers
cuda-driversさらに調べると、リポジトリにはnvidia-driver-615という実体パッケージは存在せず、nvidia-driver-pinning-615(615系を優先させるためのピン留め設定ファイル)だけが置かれていました。このピン留めのせいで、存在しないバージョンを指し続けて空回りしていたわけです。
ピン留めを外し、実体のある最新版を直接指定して解決しました。
rm -f /etc/apt/preferences.d/*nvidia-driver-pinning*
apt-get install -y nvidia-driver-610
$ nvidia-smi
NVIDIA-SMI 610.43.02 KMD Version: 610.43.02 CUDA UMD Version: 13.3Python.hが無いとTritonのJITが落ちる
fatal error: Python.h: No such file or directoryvLLMは内部でTritonというツールを使っています。GPU上で動く処理を実行時にその場でコンパイルする仕組みなのですが、このコンパイルにPythonの開発用ヘッダーファイルが必要でした。python3-devを入れて解決。仮想環境を作るときにpython3-venvだけ入れて満足していると踏みます。
Mambaキャッシュのブロック数がデフォルト値と噛み合わない
ここで少し前提の説明が必要です。Qwen3.8-27Bは、一般的なTransformerとは少し違う構造をしています。64層あるうち48層を「線形アテンション(Mamba系)」と呼ばれる別方式に置き換えたハイブリッド構成です。
ざっくり言うと、通常のTransformerは過去の文脈をすべて保持するぶんメモリを食いますが、Mamba系は文脈を圧縮した「状態」として持ち回るため軽くなります。そのかわり、この状態を保存しておく専用のキャッシュ領域が別途必要になります。
この構造が、vLLMのデフォルト設定と何度もぶつかりました。
ValueError: max_num_seqs (1024) exceeds available Mamba cache blocks (234).
Please lower max_num_seqs to at most 234 or increase gpu_memory_utilization.
同時に処理できるリクエスト数のデフォルト値(1024)が、先ほどのMamba用キャッシュのブロック数(234)を素で超えていました。1リクエストにつき1ブロック必要なので、そもそも足りていないわけです。
さらにCUDAグラフ(GPUの処理手順を事前に記録して高速化する仕組み)の初期化時にもメモリ不足が出たため、--max-num-seqsと--gpu-memory-utilizationをあわせて手当てしました。
Claude Codeのシステムプロンプトだけでコンテキストが溢れる
This model's maximum context length is 32768 tokens. However, you requested
32000 output tokens and your prompt contains 147948 characters
14万文字。Claude Codeはツール定義を含むシステムプロンプトだけでかなりの分量を送ってきます。--max-model-lenを131072まで広げ、代わりに--max-num-seqsを16まで絞ってメモリ収支を合わせました。
あわせてreasoning_effortの対応値も違いました。これはモデルにどれくらい深く考えさせるかを指示するパラメータです。Claude Codeのデフォルトはhighですが、
API Error: 400 Unexpected reasoning effort high.
Supported types are xhigh (default), medium, and low.CLAUDE_CODE_EFFORT_LEVEL=mediumで回避しています。
ハマりどころ3:エラーを出さずに失敗する
ドライバもコンテキスト長も片付いて、ようやくclaudeから応答が返るようになりました。動作確認に簡単なファイル作成を頼みます。
思考ログにはこう書かれていました。
Let me create a simple HTML file. I'll use the Write tool.
The working directory is /home/hiroaki/projects/sakura-ai-bench.
そして処理は正常に完了します。エラーは出ません。
$ ls -la
-rw-r--r-- 1 hiroaki hiroaki 693 Sep 12 02:02 index.htmlタイムスタンプが更新されていません。このファイルは、別のモデルで動作確認したときに作られたものでした。 つまり今回のリクエストでは、ファイルは1つも作られていない。「Writeツールを使う」と言いながら、実際には何も起きていなかったわけです。
原因はツール呼び出しパーサーの指定ミスでした。
前提として、LLMがファイル編集やコマンド実行をする仕組みを整理しておきます。モデル自身がファイルを書けるわけではなく、実際には「このツールをこの引数で呼んでほしい」という依頼を、決められた書式のテキストで出力しているだけです。そのテキストを解析して実際のツール実行に変換するのが、推論サーバ側の「ツール呼び出しパーサー」の役目になります。
vLLMでこれを有効にするには、--enable-auto-tool-choiceに加えて--tool-call-parserでパーサーを指定します。ここでQwen向けの定番として広く使われているhermesを指定していたのですが、これが噛み合っていませんでした。
--tool-call-parserが解釈するのは「モデルがどういうテキスト形式でツール呼び出しを書き出すか」です。この書式は学習時に叩き込まれたものなので、モデルごとに違います。
hermesが期待する形式:<tool_call>{"name": "...", "arguments": {...}}</tool_call>(JSON)- Qwen3系が実際に出力する形式:
<tool_call><function=name><parameter=key>value</parameter></function></tool_call>(XML)
形式が違うので、パーサーはツール呼び出しを1つも抽出できません。そして抽出できなかったことをエラーにせず、単なる本文テキストとして黙って通します。だから「エラーは出ないが何も起きない」という状態になっていました。
vLLMにはQwen3系専用のqwen3_xmlパーサーが用意されています。切り替えたところ、一発で通りました。
● Write(hello.html)
  Wrote 11 lines to hello.html
最終的な起動コマンドはこうなりました。
vllm serve Qwen/Qwen3.8-27B --host 0.0.0.0 --port 8000 \
  --max-model-len 131072 --gpu-memory-utilization 0.85 \
  --enable-auto-tool-choice --tool-call-parser qwen3_xml \
  --reasoning-parser qwen3 \
--max-num-seqs 16ちなみに--reasoning-parser qwen3を付けないと、モデルの思考内容(<think>タグの中身)が分離されず、そのまま本文として画面に流れ出てきます。これはこれで後述する面白い発見に繋がったのですが、通常は指定しておくべきです。
ハマりどころ4:2ターン目で毎回ハングする(未解決)
単発の生成は動くようになりました。ところが「ファイルを書き込む → その結果を受けて会話を続ける」という2ターン目に入った瞬間、応答が返ってこなくなります。
$ nvidia-smi
| N/A 27C P0 114W / 700W | 69325MiB / 81559MiB | 0% Default |GPUメモリは69GB確保されたままなのでプロセスは生きています。しかしGPU使用率が0%。ここが重要で、もしモデルが時間をかけて考え込んでいるだけなら使用率は上がっているはずです。0%ということは、計算そのものが行われていない——つまり推論が進んでいるのではなく、完全に止まっているということになります。
--reasoning-parser qwen3を追加しても、プロンプトに「ファイルを書き込んだら完了としてください。追加の検証は不要です」と明記しても、3回中3回同じ状態になりました。
救いだったのは、止まる箇所が生成後の後続処理だったことです。ファイル自体は毎回正常に書き込まれた状態で止まっていたので、生成結果の回収はできました。
原因は特定できていません。1ターン目は毎回完走し、ツール実行結果を返した直後の継続生成でだけ再現することから、Mamba系レイヤーの状態をターンをまたいで引き継ぐ処理あたりを疑っていますが、確証はありません。Qwen3.8-27Bは公開からまだ1か月ほど、vLLM側のハイブリッドアテンション対応も比較的新しい部分です。そのあたりのエッジケースを踏んでいる可能性はあります。
いずれにせよ、Claude Codeのような継続的なエージェント用途では、現状かなり心もとない安定性です。
結果:無料枠モデルは本家にどこまで迫れるか
お題に戻ります。3モデルの結果です。
なお、最初に手元のブラウザで確認した際、ウィンドウサイズを変えると粒子密度が変わり、収束の見え方まで変わってしまうことに気づきました。お題にCanvasサイズを明記していなかったためです。以下のGIFは、全モデルとも1200×800の同一条件で録画し直しています。
| Claude Sonnet 5 | Kimi-K2.6 | Qwen3.8-27B | |
|---|---|---|---|
| 位置づけ | 本家・有料 | 無料枠・プレビュー | 自前ホスト |
| 所要時間 | 43秒 | 59秒(※) | 計測不能 |
| 生成コード | 199行 | 203行 | 207行 |
| 一発成功 | ○ | ○ | ○ |
| 収束の傾向 | 中小の塊が均等に分散 | 大きな塊に強く凝集 | 大きな塊に強く凝集 |
※ストリーミング応答のリトライを含む時間
Claude Sonnet 5
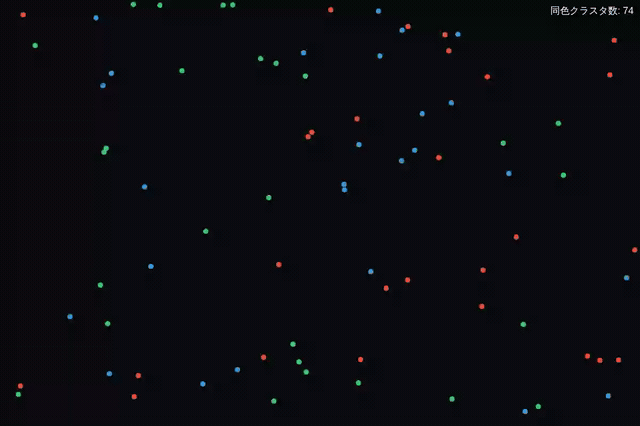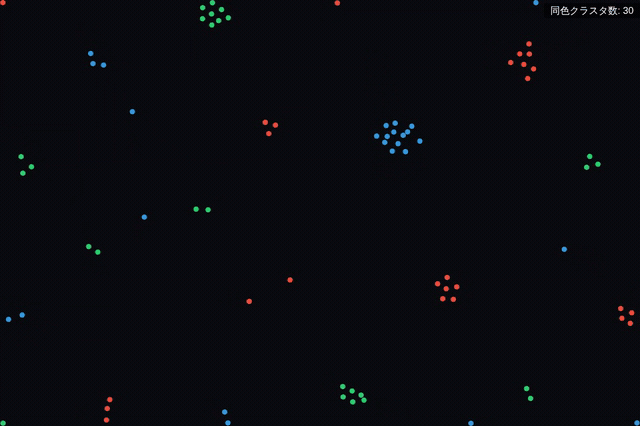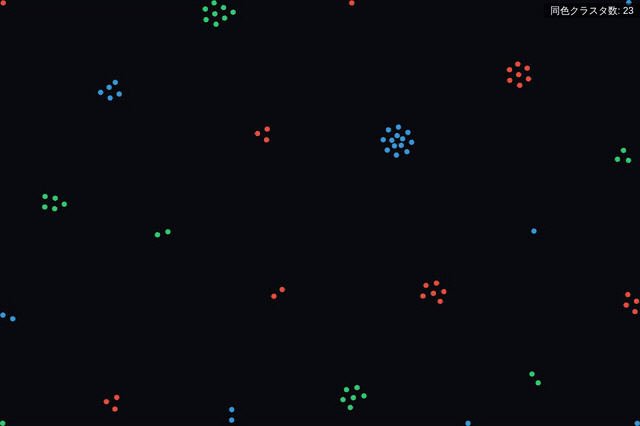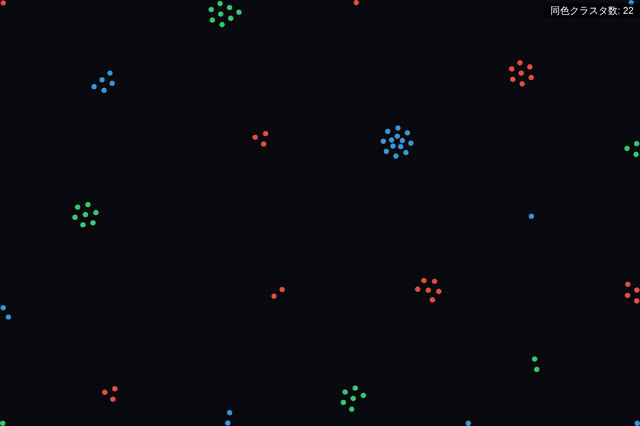
一番素直な実装でした。摩擦0.985、最大速度4、相互作用距離に上限を設ける設計で、個々の粒子の輪郭が最後まで見えるくらいの緩やかな収束をします。3モデルの中で唯一、接続からお題の完了までノートラブルでした。
Kimi-K2.6(無料枠)
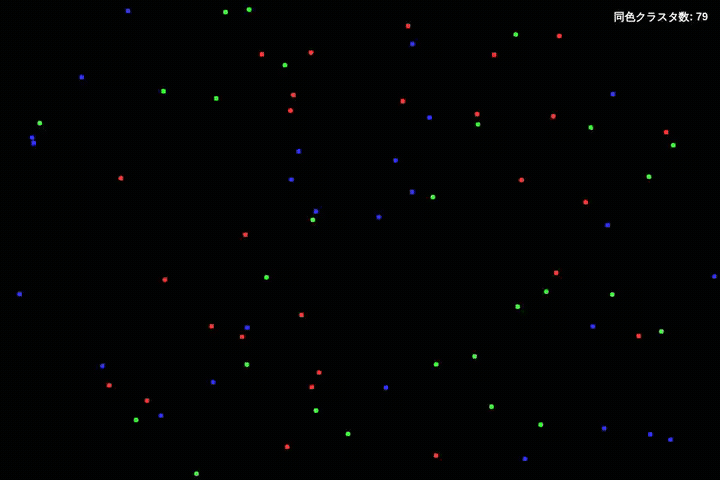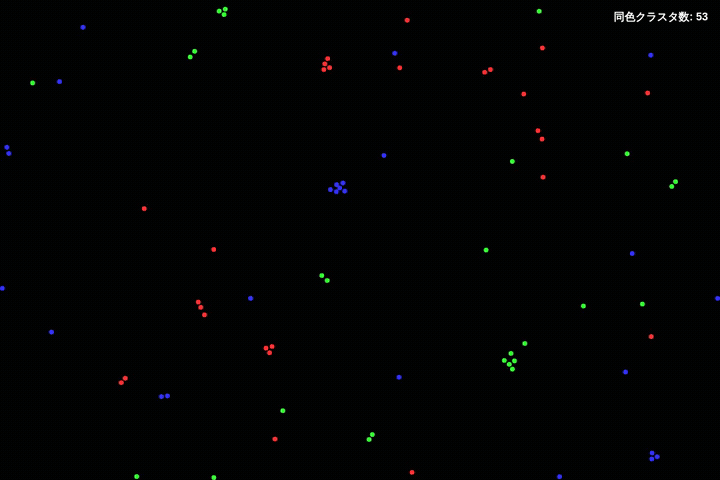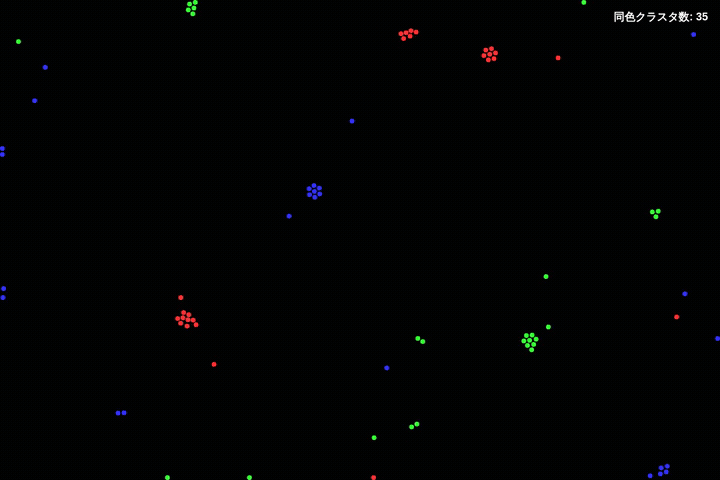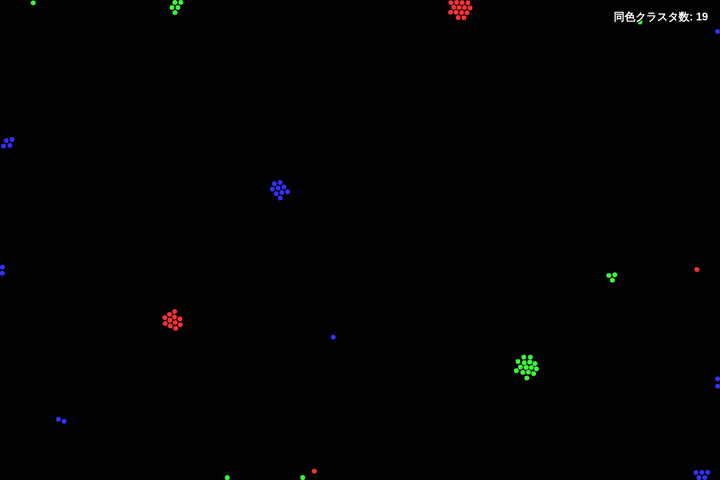
無料のパブリックプレビューモデルの結果とは思えませんでした。引力係数を強めに取る実装を選んだようで、Sonnet 5より明確に大きく密度の高いクラスタへ収束していきます。「同色で集まる」という現象の見え方としては、こちらのほうが分かりやすいくらいです。
接続直後の動作確認で「Streaming response ended before any complete data was received. Retrying without streaming.」という警告が出て、Claude Codeが自動的に非ストリーミングへフォールバックする場面がありました。実害はありませんでしたが、レイテンシを計測する用途では頭に入れておく必要があります。
料金面でも触れておくと、Kimi-K2.6はさくらのAI Engine内では最も高い部類のモデル(Input 0.6円/Output 3円 per 万トークン)です。それでもAnthropic本家Sonnet 5(Input 約4.5円/Output 約22.5円 ※1ドル150円換算)の7分の1程度で、チャット生成は月3,000リクエストまで無償枠があります。今回の結果は、その無償枠の中で得られたものです。
Qwen3.8-27B(自前ホスト)
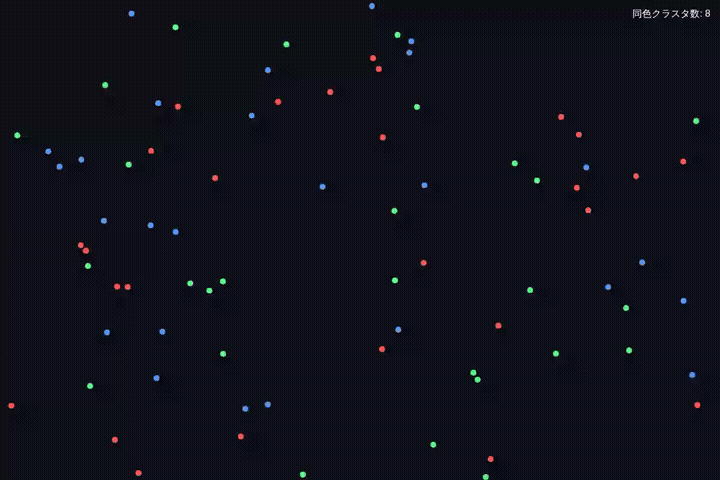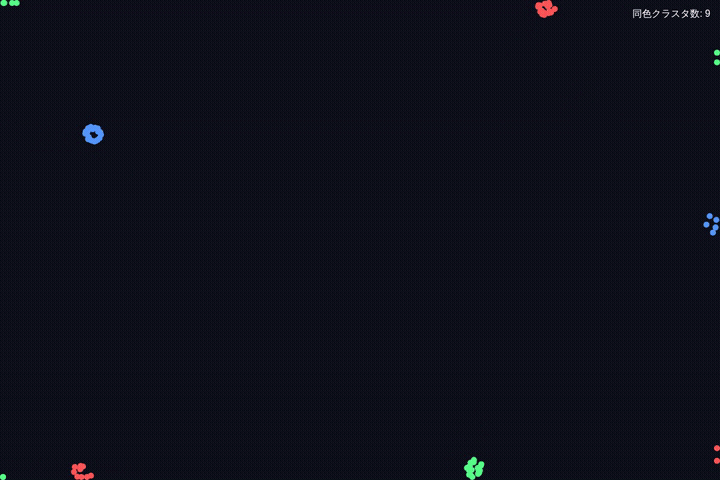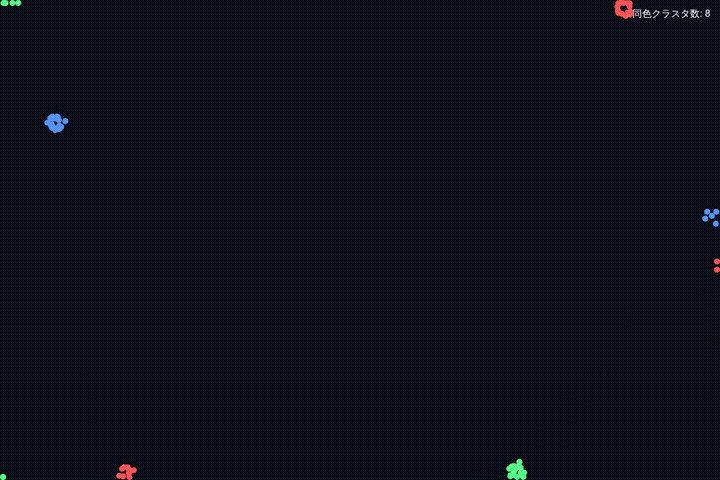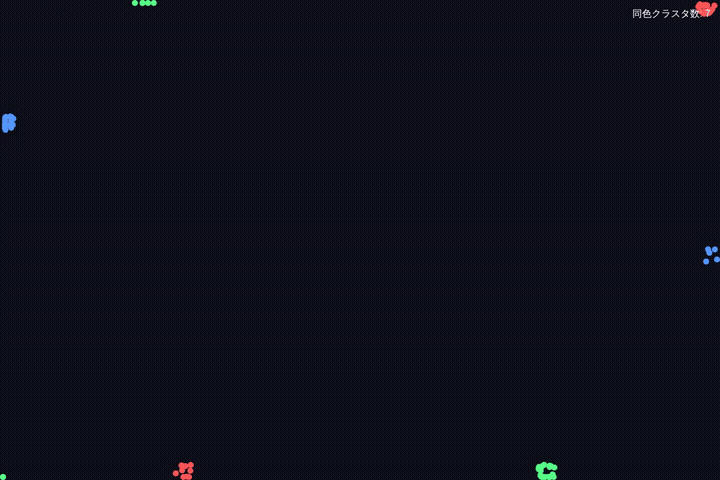
コードの質としてはKimiと並ぶ結果でした。個人的に一番面白かったのは、--reasoning-parserを設定する前の生の思考ログに、実装途中で自分の間違いに気づいて修正する過程がそのまま残っていたことです。
Wait — about the sign of the force: with ux, uy pointing from a to b,
a force f>0 pushes a in the direction of b? ... a gets pushed away from b. Wrong.
Fix: define f as the "force acting on a along the unit vector from a to b" ...
引力の向きの符号を間違えて書いた直後に自己検出して、書き出す前に直しています。この手の符号ミスは、実際に動かすまで気づきにくい種類のバグです。
ただし前述のとおり2ターン目のハングが毎回発生するため、Claude Codeのバックエンドとして実用するには現状まだ厳しい、というのが正直な評価です。
よかった点
ハマりどころばかりになったので、公平に書いておきます。
さくらのAI Engineへの接続は、認証方式さえ分かれば本当に環境変数3行で済みます。 ドライバもツールパーサーもコンテキスト長も、一切意識する必要がありませんでした。同じことを自前でやると何が必要になるかは、ハマりどころ2と3で書いたとおりです。マネージドであることの価値が、今回ほど身に沁みた検証はありません。
無料枠のモデルが有料の本家と遜色ない結果を出しました。 個人の検証やプロトタイピング、学習用途であれば、無償枠だけで十分実用に足ります。月3,000リクエストは、1日あたり100回。手で使う分にはかなり余裕があります。
vLLMは/v1/messagesをネイティブでサポートしています。 当初はClaude Code Router等のプロキシを挟む前提で構成を考えていたのですが、不要でした。前提知識さえあれば、セルフホストしたオープンウェイトモデルもClaude Codeから直結できます。
まとめ
- Claude Codeは
ANTHROPIC_BASE_URLで接続先を差し替えられる。さくらのAI Engineもセルフホストしたモデルも、同じ器のまま中身を入れ替えられる - さくらのAI Engineへの接続は
ANTHROPIC_AUTH_TOKEN(api_keyではない)。トークンは<ID>:<シークレット>をコロンで連結した形式 --tool-call-parserはモデルのアーキテクチャ固有。間違えるとエラーを出さずに何も起きない。Qwen3系には専用のqwen3_xmlがあるcuda-driversは実体のない移行パッケージのことがある。already the newest versionを信じずnvidia-smiで確認する- 自前ホスティングは、ドライバ・パーサー・reasoning effort・コンテキスト長と多段階にハマりどころがある
- 2ターン目のハングは対策しても再現し、未解決
- 肝心の生成物は、無料枠のKimi-K2.6が本家Sonnet 5に見劣りしない出来だった
「エラーが出ない=成功」ではない、というのは運用の現場でもよく言われることですが、それをAIエージェントの文脈で踏んだのは新鮮でした。思考ログが「やった」と言っていても、ファイルシステムを見るまでは信じない。結局のところ、検証の基本は変わらないようです。
次回は、このハングの原因をもう少し追ってみるか、あるいはさくらのAI Engineの無償枠が通常モデルとパブリックプレビューモデルで別カウントになっている点を実測で確かめてみたいと思っています。
後片付けも忘れずに。高火力VRTは起動している間は課金対象なので、検証が終わったらサーバーとディスクを削除しておきましょう。
さくらのクラウドを使ったAI活用・サーバー運用体制の整備についてご相談がある方は、ぜひネットアシストにご連絡ください。
それではまた!
参考リンク
この記事を書いた人